引言
让 AI 写一段代码,很容易看到效果。
描述需求,给出上下文,等一会儿,一份实现就摆在眼前。接着运行、修改,再运行,确实能帮开发者省下不少敲代码的工夫。
但用得多了,一个问题开始变得具体:代码生成了,怎么确认这件事真的做对了?
它有没有理解需求?方案是否合适?眼前的功能能跑,其他场景会不会受到影响?
带着这些问题,我们把 AI 用进日常研发,在真实任务里反复尝试。过程中,有些做法保留了下来,也有一些期待需要调整。这篇就聊聊其中几个变化。
先别急着让 AI 动手
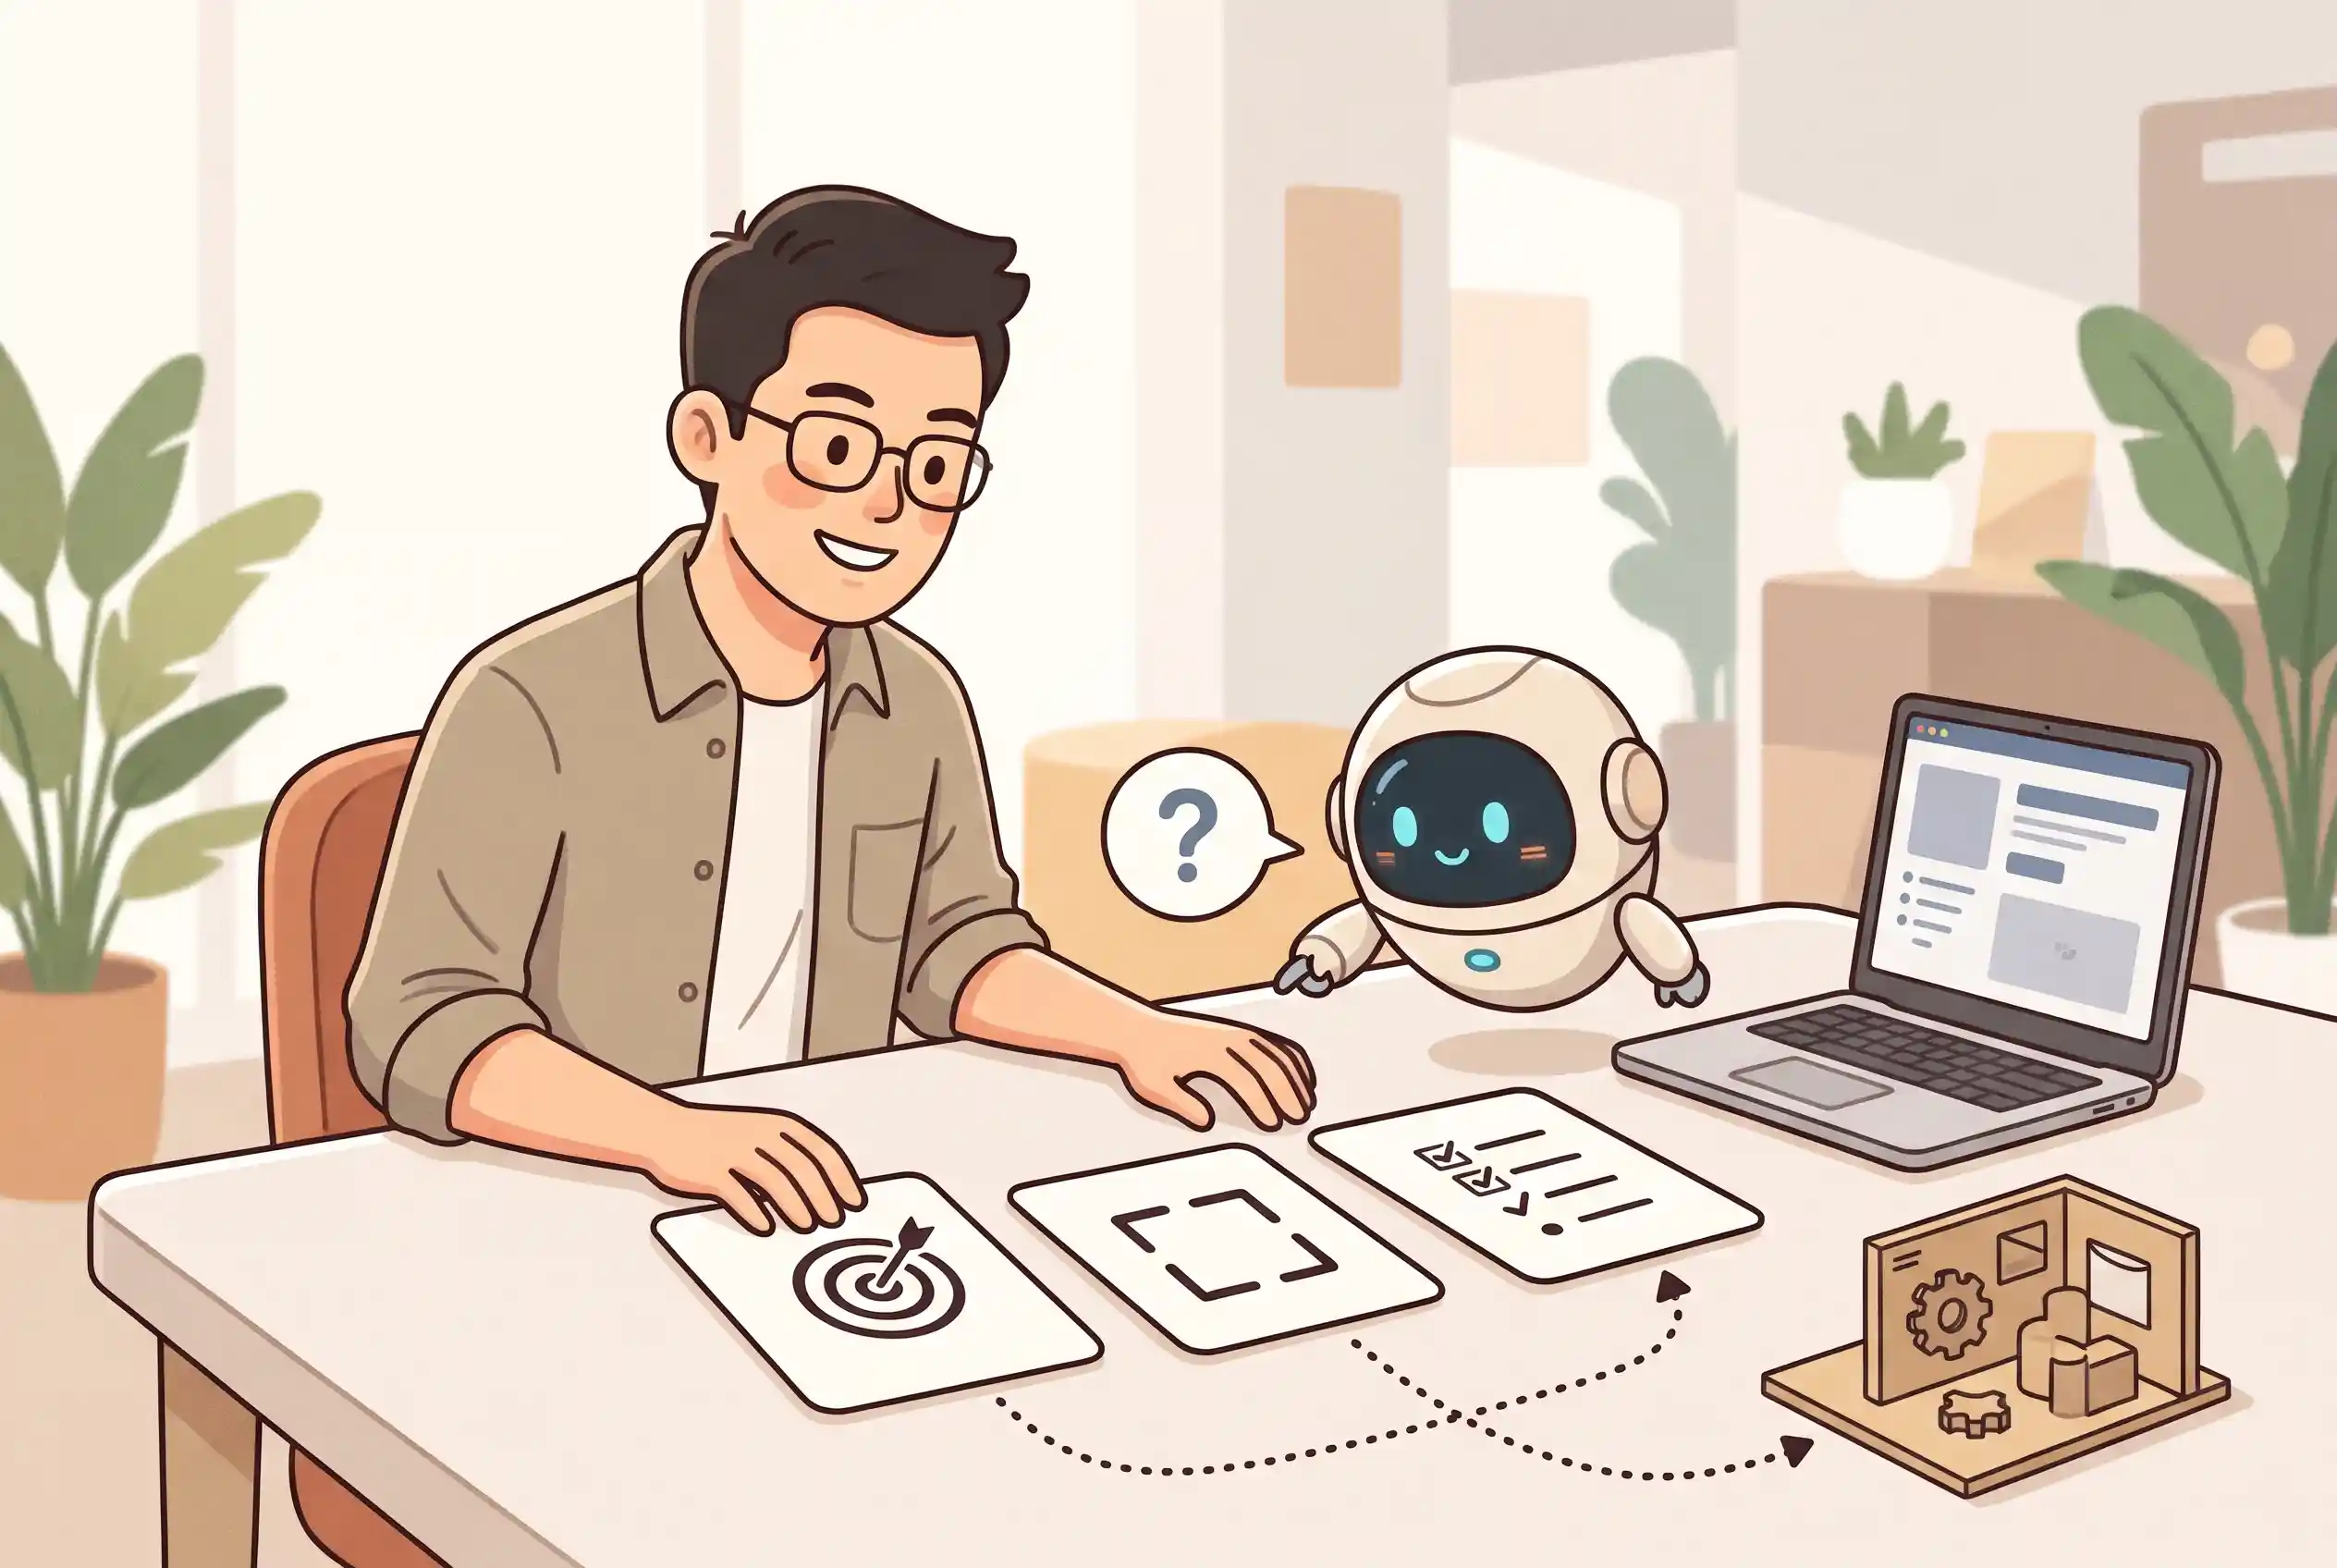
图 1动手之前,先让需求和预期对上号
拿到任务,直接把需求发给 AI,让它开始写。这种方式很有吸引力。
不过,需求里一个没说清楚的地方,可能就对应着几种不同的实现。AI 给出了其中一种,代码也能运行,并不代表它选中了我们真正需要的那一种。
比如,“这个功能需要调整一下”,听起来是一句话。真正落到开发上,还要弄清楚调整适用于哪些场景、原有行为要保留多少、什么结果才算完成。
如果这些问题还没有答案,越快进入编码,越可能把含糊的要求写成具体的代码。
所以,我们开始更重视动手之前的讨论:先把问题说清楚,让 AI 帮助补充考虑,再比较方案。
在一次功能调整中,AI 给出了几种实现思路。有的比较简单,有的划分更细,但复杂度也更高。开发者结合实际要求作出选择,再通过测试验证结果。
这件事给我们的提醒很直接:有了 AI,方案可以更快摆上桌面,取舍仍然需要人来做。
花在这一步的时间,并没有白费。后面检查实现时,大家终于有了一份可以共同对照的依据。
什么都交给 AI,未必更省事
代码审查,是我们尝试得比较深入的一个方向。
最初的想法很自然:既然 AI 能看懂代码,那就让它顺便检查代码规范,再分析功能逻辑。
实际用下来,问题出在规范检查上。同一类问题,不同次审查的判断可能不一样。反复调整后,结果仍然不够稳定。
继续调,还是换个思路?
我们选择先把任务拆开。
对于能够用明确规则检查的内容,使用静态分析工具;对于需要结合需求和代码上下文分析的问题,再让 AI 提供意见。
调整之后,审查结果更稳定了。
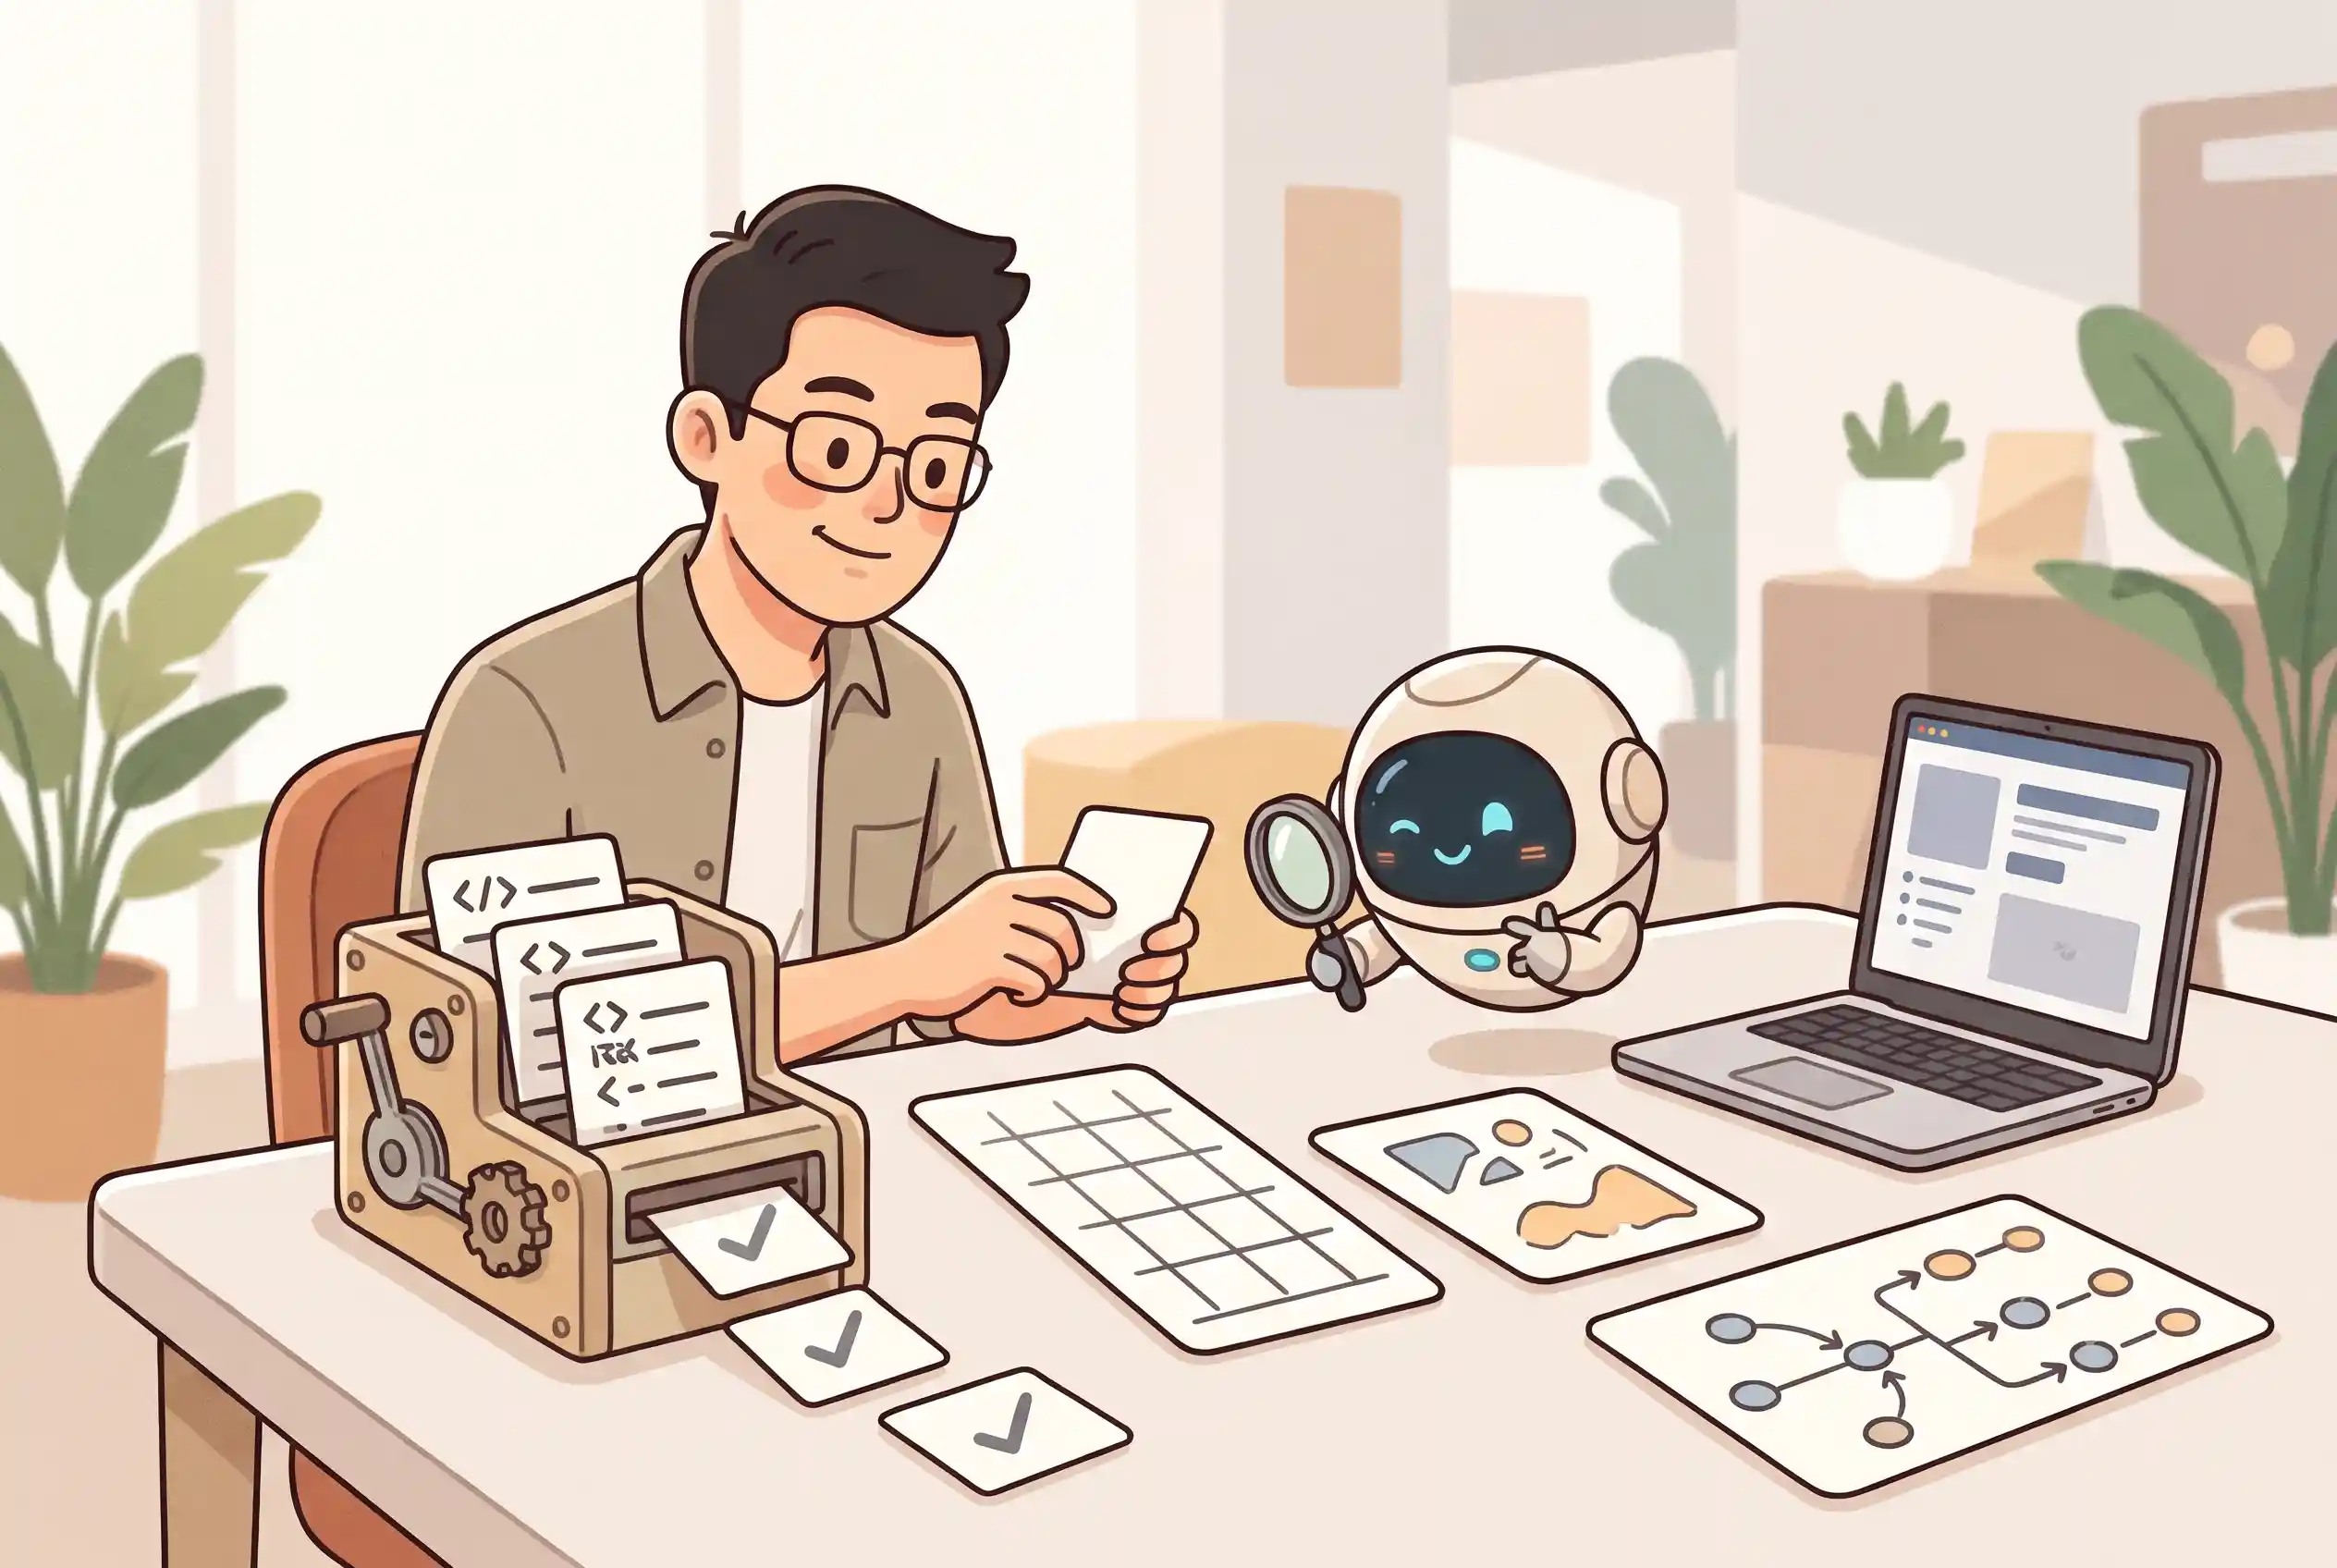
图 2规则检查求一致,上下文分析重理解
这次尝试让我们少了一点“既然用了 AI,就尽量都让它做”的执念。一个检查项有明确的规则,就用适合它的方法;一个问题需要理解上下文,再发挥 AI 的分析能力。
把工作分对,比把所有工作都交给同一种工具更有用。
被当作误报的提醒,后来怎么样了
还有一次,AI 对一处功能修改提出了提醒:某个边界场景可能受到影响。
开发者最初认为,这是误报。根据当时对需求的理解,加上已有的检查,这个判断看起来有依据。
但把审查意见、测试结果和需求重新放在一起核对后,事情有了变化。
AI 描述的现象,确实能够复现。
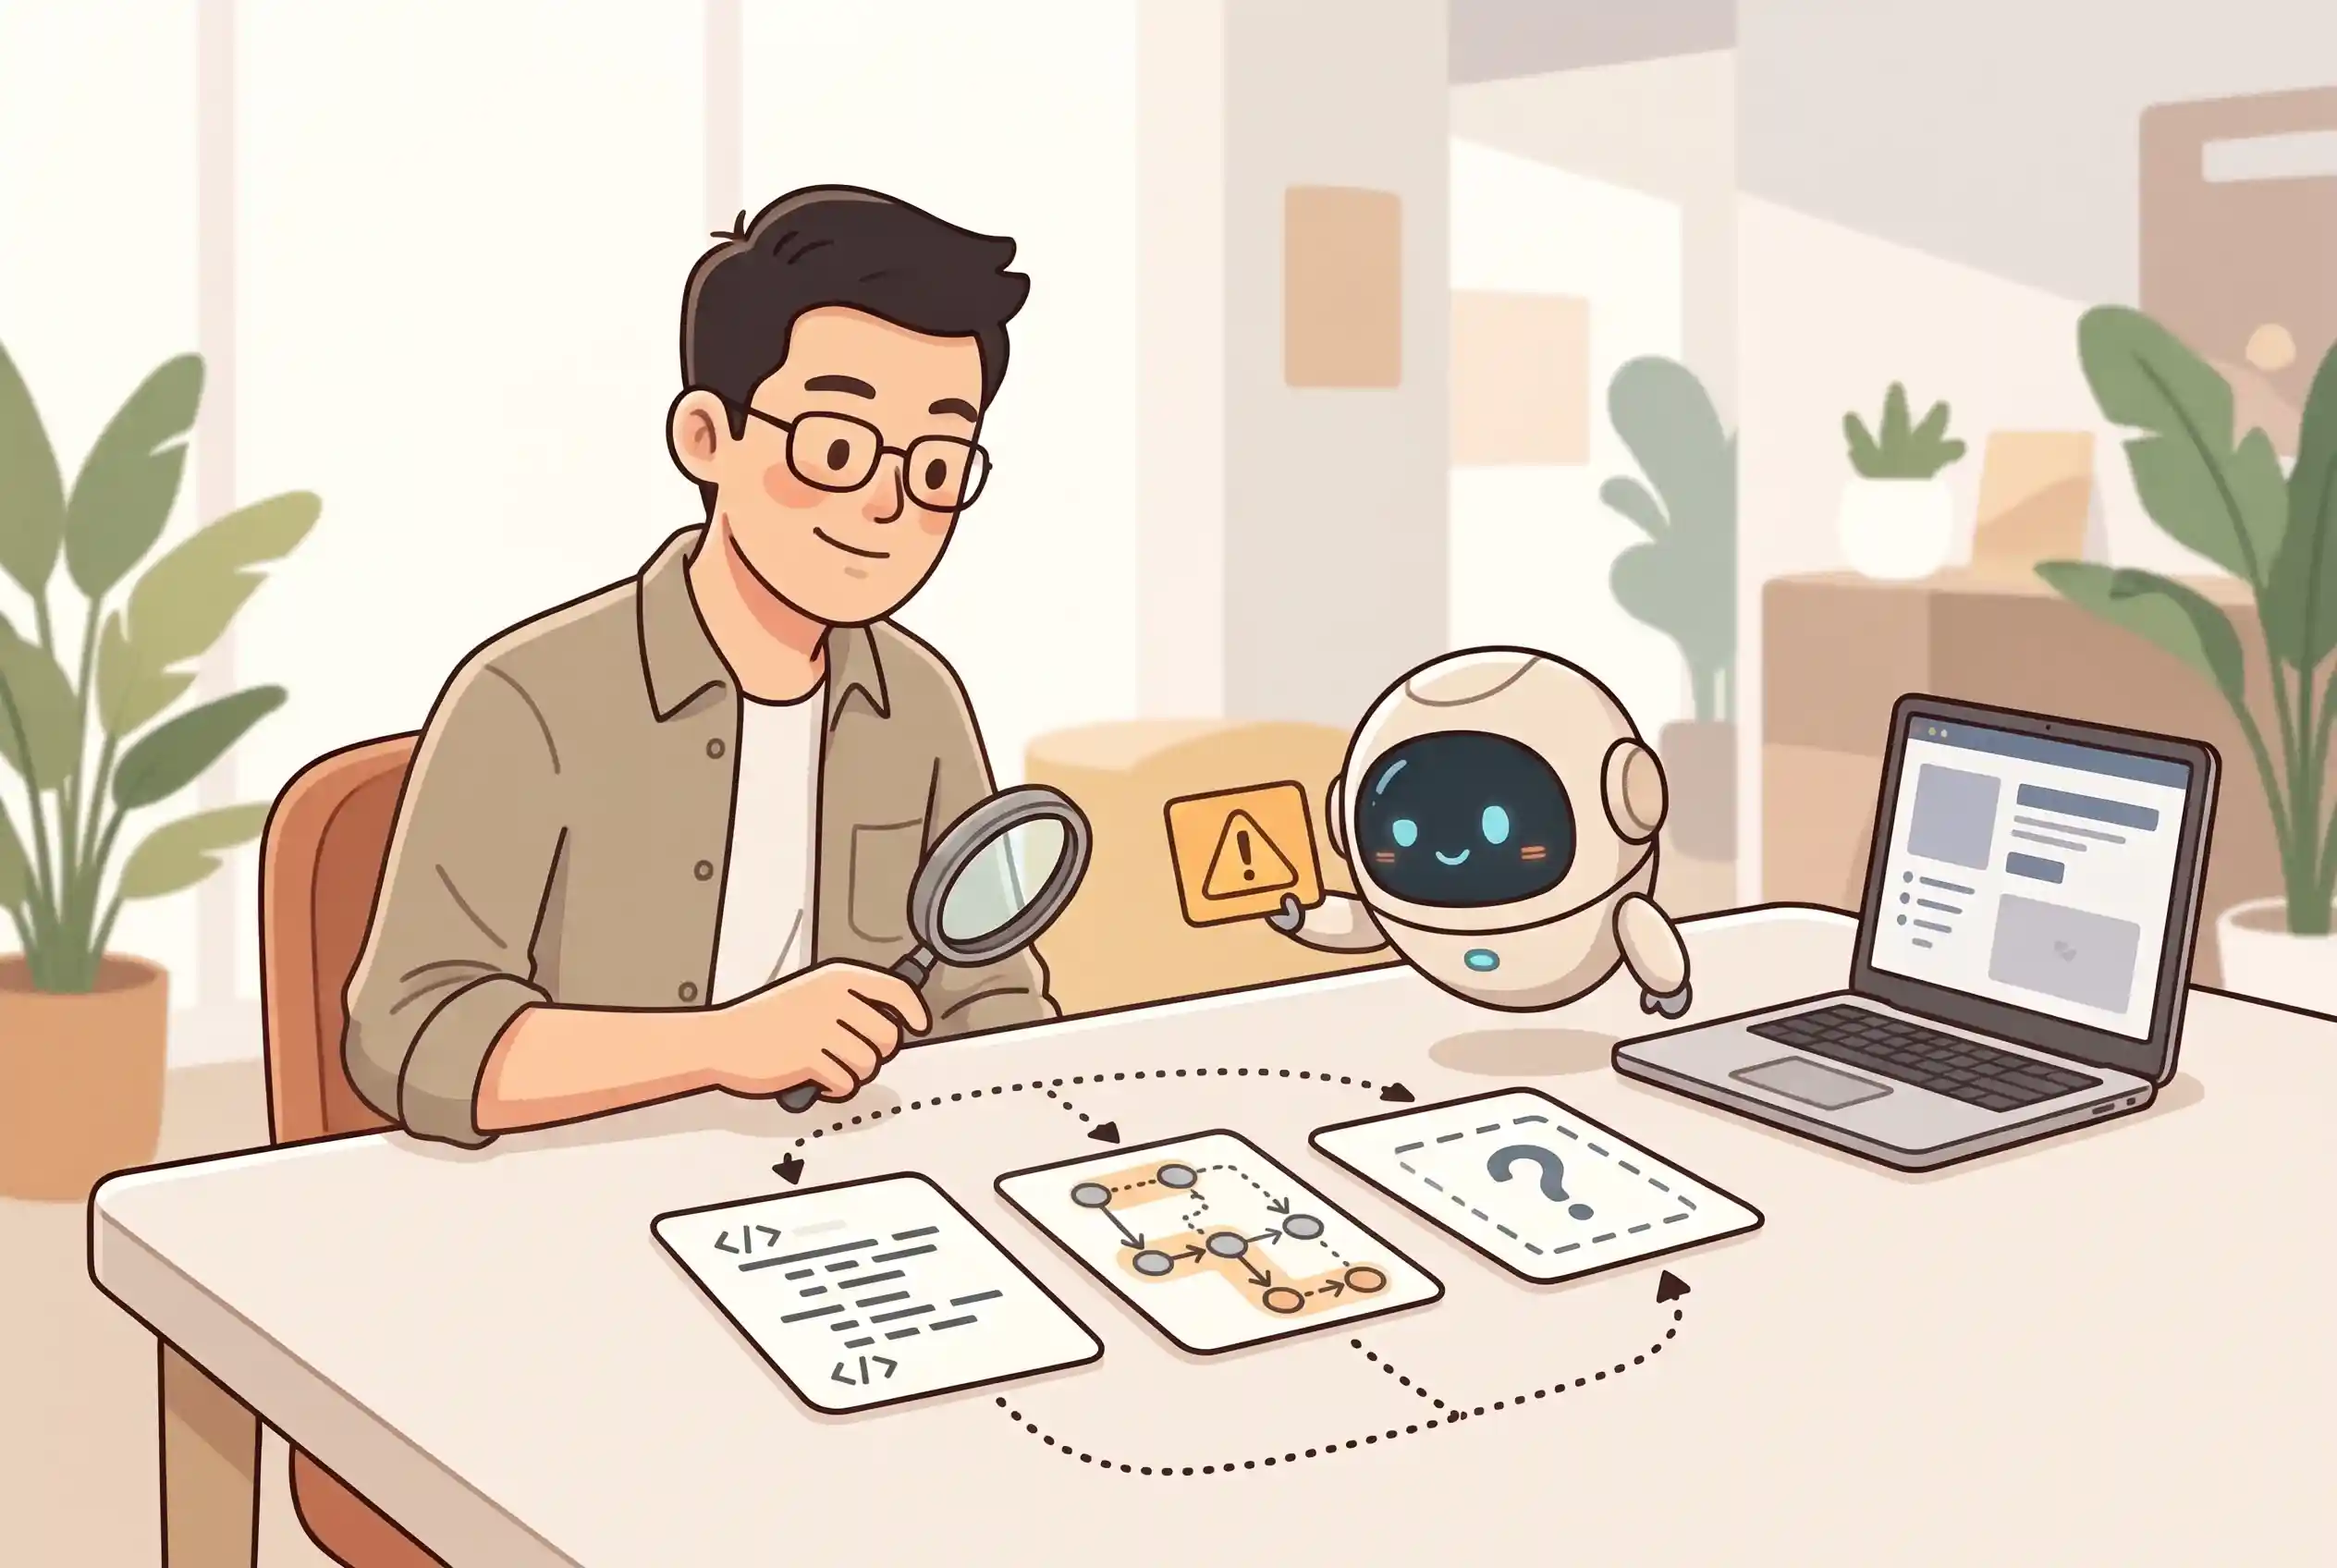
图 3发现疑点之后,还要核对现象与预期
那是不是说明,AI 找到了一个缺陷?
还不能直接下结论。因为需求没有明确说明,这类情况应该如何处理。现象已经确认,判断它是否正确的依据却还缺了一块。
问题于是从“这条审查意见是不是误报”,变成了“这里的预期到底是什么”。
这段经历很值得留下来。AI 没有替我们完成最终判断,却帮助我们发现了一个需要继续追问的地方。
它也提醒开发者:看到一条不认同的意见,可以先把它描述的条件和结果核对清楚。有时需要修改的是代码,有时需要补充的是需求,也有时,最初的判断确实需要调整。
多走这一步,才知道这条意见究竟有没有价值。
AI 给出答案之后,工作还没有结束
随着尝试深入,我们越来越关注结果的验证。
代码审查能帮助发现实现中的疑点,测试能检查特定场景下的实际行为。至于这些行为是否符合预期,还需要明确的验收标准。
这几件事连起来,AI 的建议才有地方落。
“它说已经完成了”,不能单独作为完成的依据;“这段代码看起来没问题”,也还需要运行结果来支持。需求里约定了什么,实际做出了什么,两边要对得上。
这也是我们继续探索 AI 辅助测试的出发点。先明确要测哪些场景、预期是什么,再逐步尝试自动执行、结果记录和失败反馈。
否则,自动化执行得再快,也可能只是更快地跑完了一组无法说明问题的检查。
回看这段实践,最初吸引我们的是 AI 生成代码的能力。真正用进研发之后,值得投入的事情变得更多了:把需求描述清楚,把工具安排合适,把审查意见核对明白,把结果验证到位。
这些调整没有那么炫,却决定了 AI 能否在日常工作中持续发挥作用。
我们的探索还在继续。接下来,仍会从一个个具体任务出发,完善 AI 与开发者的协作,让实现更高效,也让交付更可靠。


